
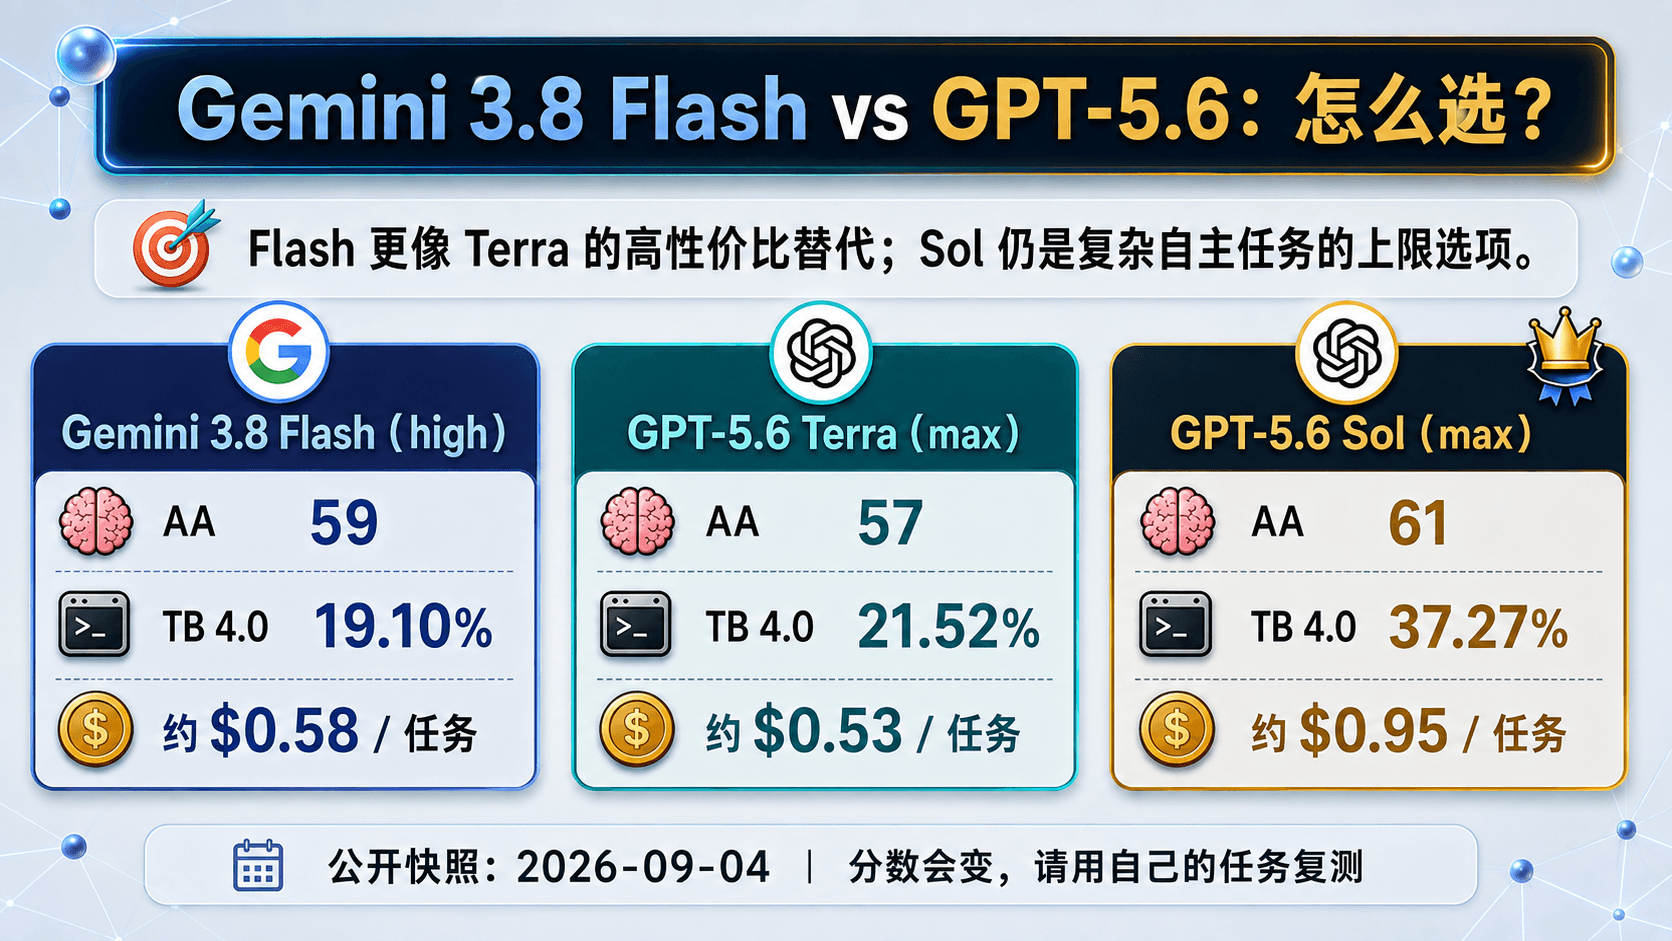
Gemini 3.8 Flash 发布后,一个很容易出现的判断是:它和 GPT-5.6 Sol 只差 2 分,Sol 可以不用了。
这句话只说对了一半。
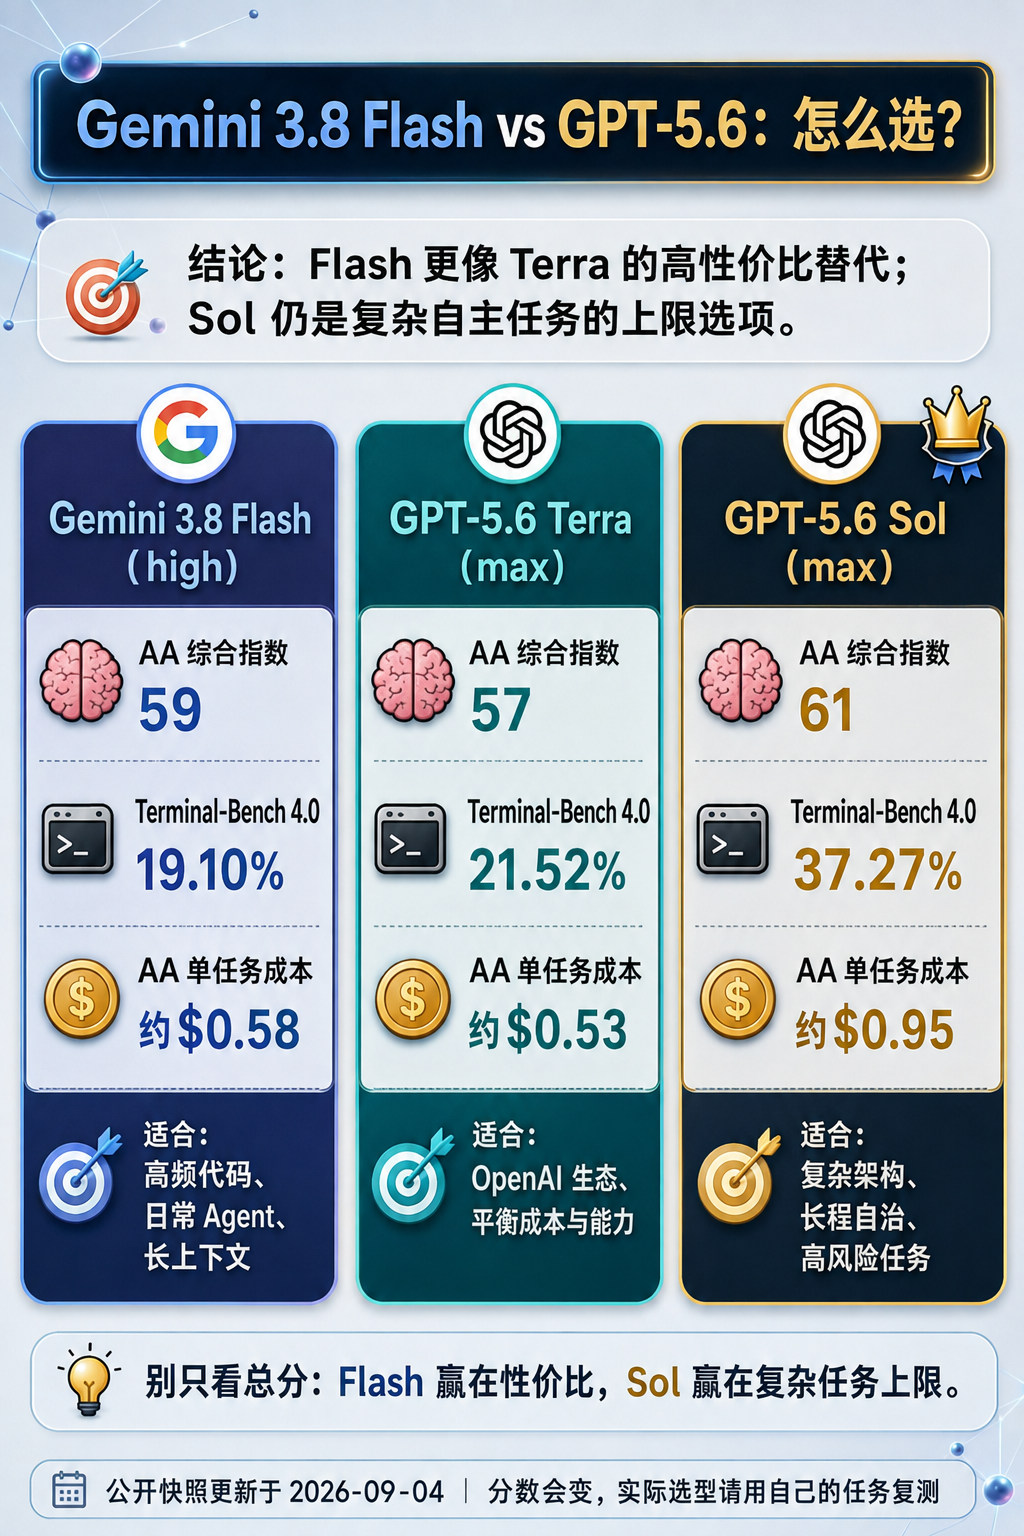
截至 2026 年 9 月 4 日,Artificial Analysis 当前快照里,Gemini 3.8 Flash(high)、GPT-5.6 Terra(max)、GPT-5.6 Sol(max)的综合指数分别是 59、57、61 分;每任务成本约为 0.58、0.53、0.95 美元。
只看综合指数,三者确实已经站在同一档。问题是,综合指数把多类能力压成了一个数字,真实工作不会只考一个总分。
任务一变,差距就出来了
换到 Terminal-Bench 4.0,当前系统快照变成了:
- Flash:19.10%
- Terra:21.52%
- Sol:37.27%
这项结果包含模型和 Agent harness,不能当成模型裸分,也不能代表全部真实任务。但它至少说明一件事:综合能力接近,不等于长链路、会调用工具、失败后还要继续恢复的复杂自主任务也接近。
所以,与其问“谁最强”,不如先问“这次做错了有多贵”。
三种任务,三种选法
高频、重复、成本敏感:先试 Flash
批量处理、日常代码、常规 Agent 和长上下文任务,更看重速度与成本。Flash 的综合指数已经进入第一梯队,适合先放进候选池。
已在 OpenAI 生态里,需要平衡:继续用 Terra
Terra 的当前综合指数和每任务成本都与 Flash 接近。如果团队已经围绕 OpenAI 的模型、工具和工作流协作,Terra 往往是更省迁移成本的均衡选择。
多步骤 Agent、长程编码、失败代价高:保留 Sol
复杂架构、长程自主执行、跨文件判断和高风险任务,最贵的不一定是模型调用,而是失败后的人工接管和整段返工。Sol 的价值主要在这里,而不是每个任务都默认使用。
别让一张总榜替你拍板
真正换模型前,可以拿自己的 10 个真实任务跑一轮:
- 选 4 个高频日常任务,观察速度与成本。
- 选 3 个需要完整理解和交付的任务,观察一次完成率。
- 选 3 个多步骤、失败代价高的任务,观察中断、接管和返工。