我之前照着网上的建议,用 Astra 做计划、Luna 做执行。
这次重新梳理才发现,我漏了一个判断:计划写好了,剩下的工作,真的都适合交给轻量模型吗?
遇到新问题,接手的模型还得判断、改方案、检查结果。我接下来怎么分工,先从这里想清楚。
1. 执行过程中,还有很多判断
假设要给网站加一个报名功能。计划可以写出“做页面、存报名信息、显示成功提示”。真正做起来,可能才发现原来的账号体系不适用,或者重复提交会产生两条记录。
这些问题也在“执行”里。接手的模型得判断原计划哪里需要调整,并把结果查清楚。
所以,我现在会先看剩下的工作有没有边界:
- 整理一批公开资料、按明确标准分类、修改已定位的小问题,可以考虑 Luna。
- 要理解整个项目、处理新问题、协调多处修改,我更倾向于让 Sol 持续负责。
这与官方对模型的定位相符:Luna 适合清晰、重复的工作;Sol 用于需要持续推进的复杂任务。模型选择仍要看实际结果。官方模型说明
2. 计划要稳定,也要允许改
我最初还把这件事理解成:“计划只能做一次,后面全是执行。”
这个说法太绝对了。
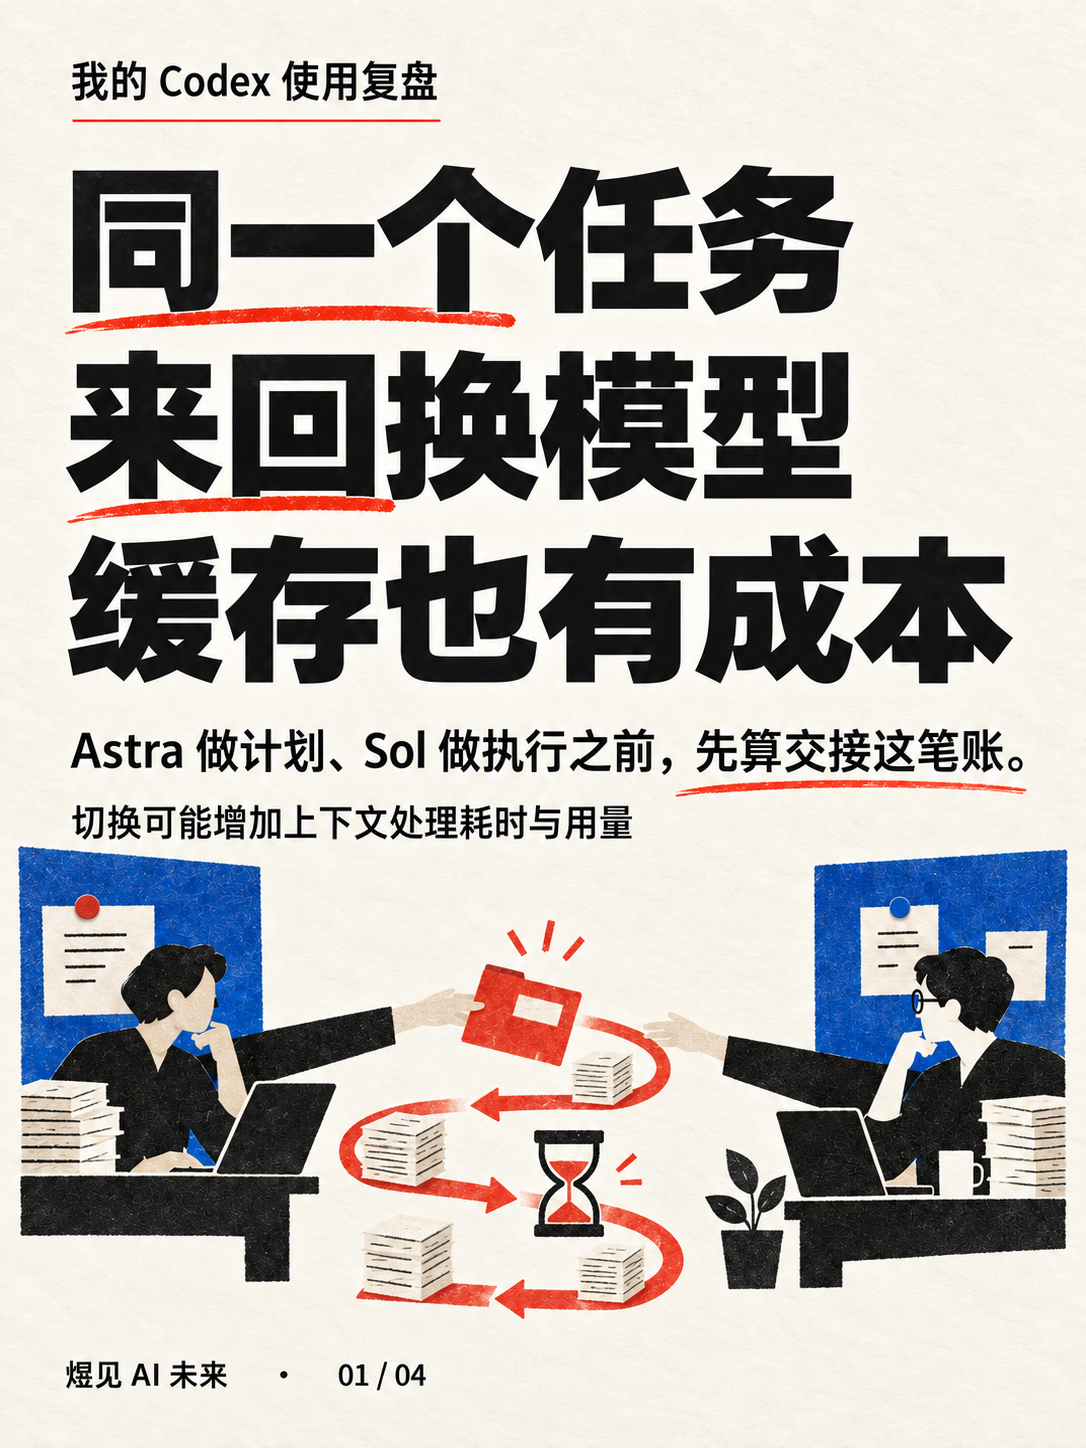
更适合我的做法是:方向确认以后,保持一份当前计划,由负责执行的模型接着推进。遇到新证据,就更新受影响的部分。
只有目标变了、关键假设不成立,或者整条路线走不通,才值得重新做大的判断。
我想避免的是每推进一点,就重新换一个模型从头规划。至于该不该改计划,要看眼前的问题。
3. 子代理能帮忙,交接也有成本
子代理就像临时请一位同事,负责一件说得清楚的事。
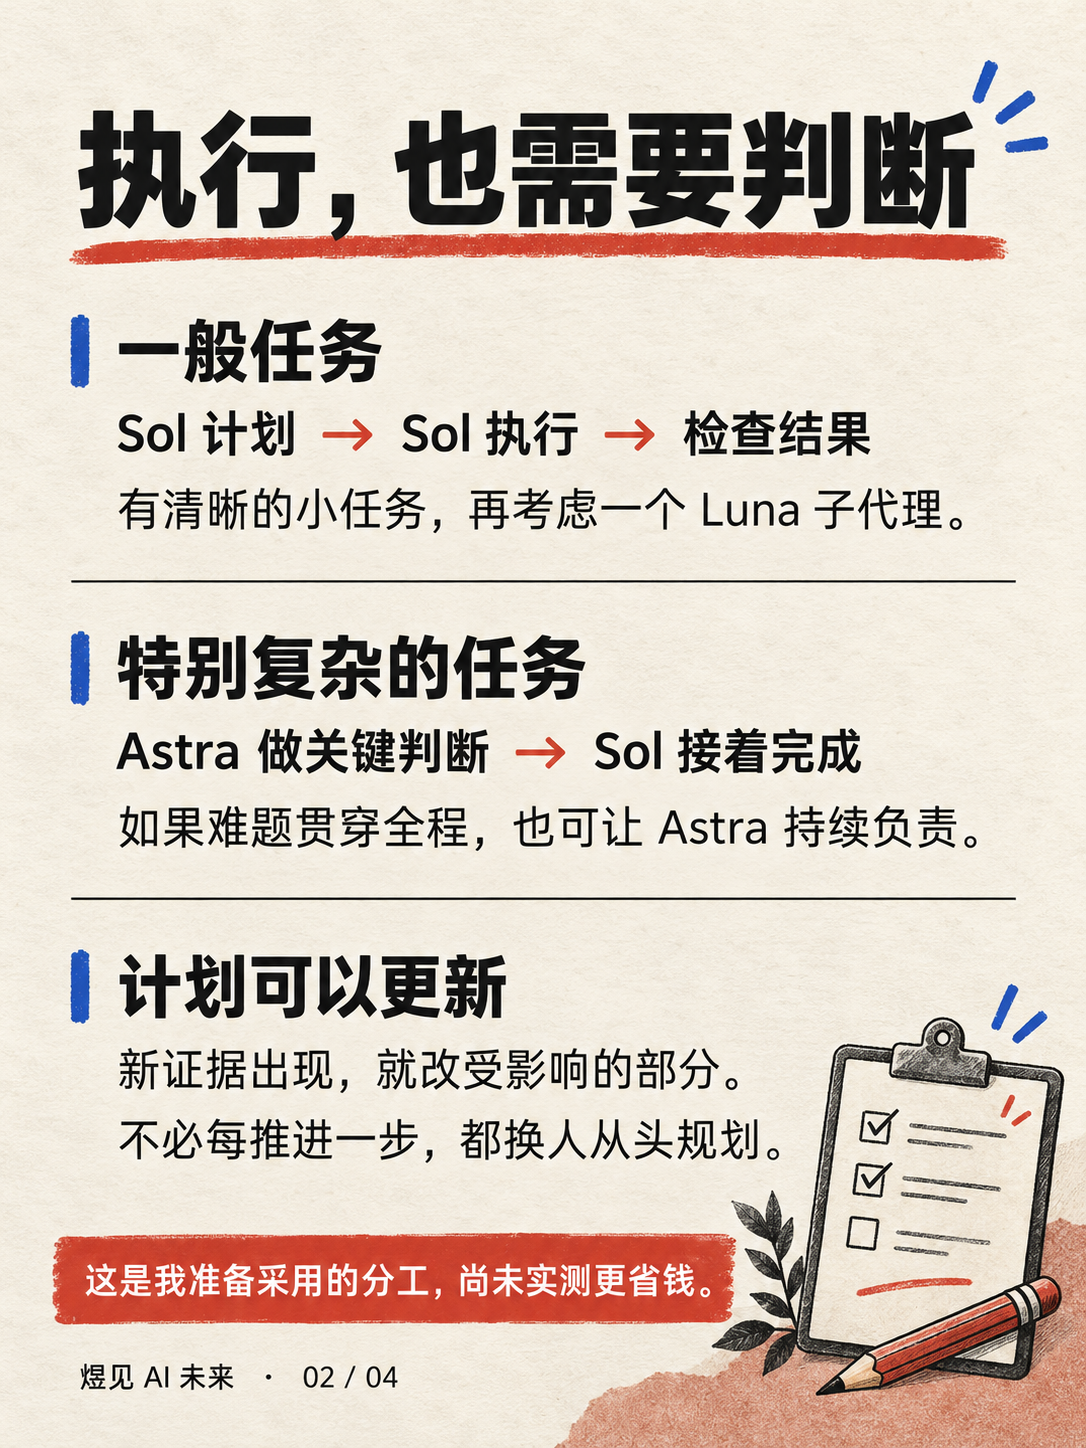
例如,让它查一个模块的现状,带回结论和文件位置;主模型继续管目标、取舍和最后验收。
这样能把大量查找过程留在支线里,主对话更容易保留关键决定。但子代理也要读取材料、调用工具、返回结果,主模型还要检查。官方明确提醒:与可比的单代理运行相比,子代理工作流会消耗更多 token。官方子代理说明
因此,“切换模型最好都通过子代理”也不能当成通用规则。
对我来说,先把三件事交代清楚更重要:具体做什么、依据在哪里、做到什么程度算完成。
至于是否值得多开一个代理,要把交接和检查的工作一起算进去。
4. 同一个任务里,换模型也有缓存和效率成本
在一个任务中切换模型,不能默认继续复用原模型的缓存。重新处理上下文,可能增加耗时和输入处理成本。
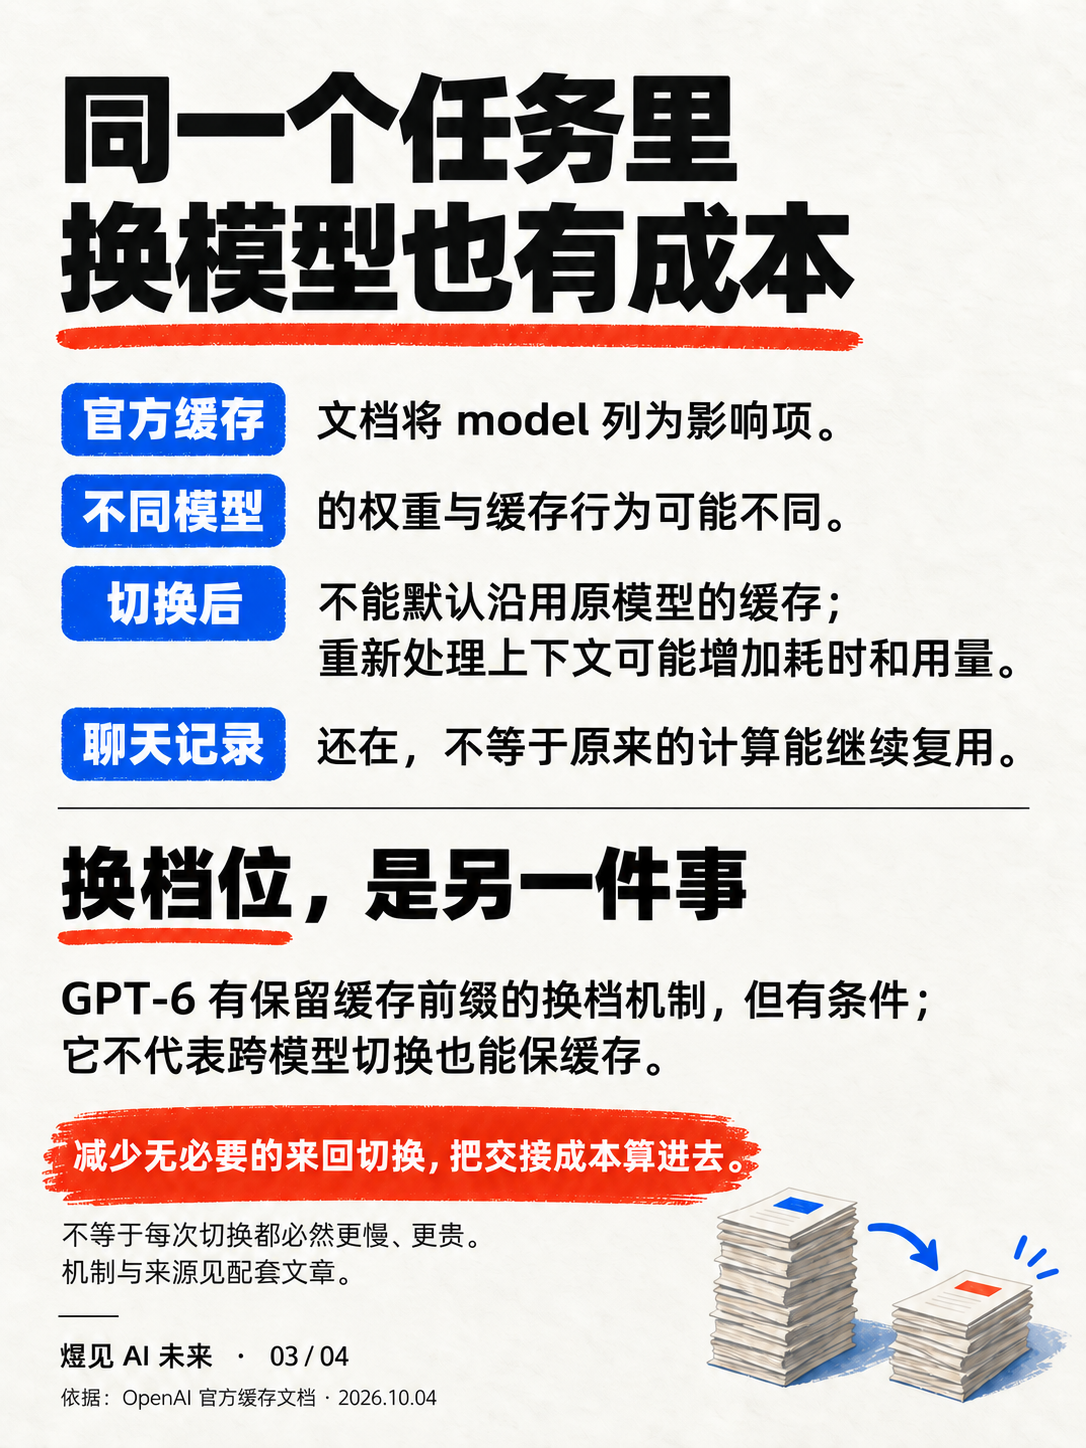
OpenAI 官方缓存文档明确把 model 列为影响缓存的设置项:不同模型可能使用不同的权重和缓存行为。缓存保存的是计算状态,聊天记录还在,并不代表原来的计算能直接沿用。官方缓存说明
这也是我准备减少来回切换的原因。Astra 做完关键判断再交给 Sol,可以作为一种分工,但要把这次交接的成本算进去,不能只比较两个模型的单次价格。
换模型与同一模型换档位要分开看。GPT-6 的 API 有保留原缓存前缀的换档机制,但有使用条件,也不代表跨模型切换能保缓存。具体条件放在文末。
这不等于每次切换都必然更慢、更贵;最终效率还要看接手模型的速度、任务完成质量和返工。我的原则是减少无必要的来回切换,需要更合适的能力时仍然可以换。
我接下来准备这样用
一般任务:Sol 负责计划、执行和检查。 有边界清楚、确实值得拆出去的活,再考虑一个 Luna 子代理。“最多一个”是我目前控制复杂度的个人选择。
特别复杂的任务:按需要让 Astra 先做关键判断,再由 Sol 接着完成。 交接时带上目标、限制、当前方案、已确认事实和验收要求。若后面仍不断遇到困难判断,也可以让 Astra 持续负责;不能预设每个复杂任务都适合中途换人。
评价时看整件事。 最后有没有做对,我补充解释了几次,返工多不多,整段耗时和总用量怎样。
我现在选模型,会先看接下来的工作还需要多少判断,再把切换、重新处理上下文和检查结果的成本一起算进去。
能说清楚任务、材料和验收要求,再考虑拆出去;还需要持续理解和取舍的,就让能承担这部分判断的模型接着做。
这也是我想继续记录的:模型搭配建议里,那些真正用起来才会注意到的细节。
——煜见 AI 未来
本文记录个人理解的修正与准备采用的方式,尚未进行省时、省钱或缓存命中率的对照实测。事实核对日期:2026 年 10 月 4 日。
技术补充:缓存与换档的适用条件
上下文是这次交给模型看的材料;缓存是已有输入计算能否复用。官方说明,复用依赖匹配的输入前缀,模型、推理设置、工具定义和历史内容的变化都可能影响它。官方缓存说明
GPT-6 的 Responses API 支持保持请求级推理设置不变,通过追加 configuration_update 调整后续推理强度,保留原缓存前缀。适用范围是标准单智能体模式,不能与自动压缩或自动截断组合;独立压缩端点也不接受含这类更新的历史。显式触发压缩后,需重新追加所需档位的更新。官方换档说明
这说明 API 提供了相关能力,不能单凭它判断当前 Codex 客户端每次点击换档的实际处理方式。本次没有读取客户端请求和缓存命中数据。
5.6 保持合适档位稳定,是减少不必要变化的使用建议,不代表它禁止换档。GPT-6 也应按实际客户端实现判断缓存影响。路线需要调整时,应先把任务做对。